
introduzione
La corrispondenza delle stringhe è un argomento molto importante nel più ampio dominio dell’elaborazione del testo. Gli algoritmi di corrispondenza delle stringhe sono componenti di base utilizzati nelle implementazioni di software pratici esistenti nella maggior parte dei sistemi operativi. Inoltre, enfatizzano i metodi di programmazione che fungono da paradigmi in altri campi dell’informatica (progettazione di sistemi o software). Infine, svolgono anche un ruolo importante nell’informatica teorica fornendo problemi impegnativi.
Sebbene i dati vengano memorizzati in vari modi, il testo rimane la forma principale per lo scambio di informazioni. Ciò è particolarmente evidente in letteratura o linguistica, dove i dati sono composti da enormi corpus e dizionari. Questo vale anche per l’informatica, dove una grande quantità di dati è archiviata in file lineari. E questo è anche il caso, ad esempio, nella biologia molecolare perché le molecole biologiche possono spesso essere approssimate come sequenze di nucleotidi o amminoacidi. Inoltre, la quantità di dati disponibili in questi campi tende a raddoppiare ogni diciotto mesi. Questo è il motivo per cui gli algoritmi dovrebbero essere efficienti anche se la velocità e la capacità di archiviazione dei computer aumentano regolarmente.
String-matching consiste nel trovare una, o più in generale, tutte le occorrenze di una stringa (più generalmente detta pattern ) in un testo . Tutti gli algoritmi in questo libro restituiscono tutte le occorrenze del modello nel testo. Il modello è denotato da x =x[0 .. m -1]; la sua lunghezza è pari a m . Il testo è indicato con y =y[0 .. n -1]; la sua lunghezza è pari a n . Entrambe le stringhe sono costruite su un insieme finito di caratteri chiamato alfabeto denotato da  con dimensione uguale a
 .
Le applicazioni richiedono due tipi di soluzione a seconda di quale stringa, modello o testo viene fornita per prima. Algoritmi basati sull’uso di automi o proprietà combinatorie di stringhe sono comunemente implementati per preelaborare il pattern e risolvere il primo tipo di problema. La nozione di indici realizzati da alberi o automi viene utilizzata nel secondo tipo di soluzioni. Questo libro indagherà solo gli algoritmi del primo tipo.
Gli algoritmi di corrispondenza delle stringhe del presente libro funzionano come segue. Scansionano il testo con l’aiuto di una finestra la cui dimensione è generalmente pari a m . Prima allineano le estremità sinistre della finestra e il testo, quindi confrontano i caratteri della finestra con i caratteri del modello – questo lavoro specifico è chiamato tentativo – e dopo un’intera corrispondenza del modello o dopo una mancata corrispondenza spostano il finestra a destra. Ripetono di nuovo la stessa procedura finché l’estremità destra della finestra non supera l’estremità destra del testo. Questo meccanismo è solitamente chiamato meccanismo della finestra scorrevole . Associamo ogni tentativo alla posizione j nel testo quando la finestra è posizionata suy [ j .. j + m-1 ].
L’ algoritmo Brute Force individua tutte le occorrenze di x in y nel tempo O( mn ). I numerosi miglioramenti del metodo della forza bruta possono essere classificati in base all’ordine in cui hanno eseguito i confronti tra caratteri del modello e caratteri di testo e ad ogni tentativo. Si presentano quattro categorie: il modo più naturale per eseguire i confronti è da sinistra a destra, che è la direzione di lettura; eseguire i confronti da destra a sinistra generalmente porta ai migliori algoritmi in pratica; i migliori limiti teorici si raggiungono quando i confronti sono fatti in un ordine specifico; infine esistono degli algoritmi per i quali l’ordine in cui vengono effettuati i confronti non è rilevante (tale è l’algoritmo della forza bruta).Da sinistra a destra
L’hashing fornisce un metodo semplice che evita il numero quadratico dei confronti di caratteri nella maggior parte delle situazioni pratiche e che funziona in tempo lineare sotto ipotesi probabilistiche ragionevoli. È stato introdotto da Harrison e successivamente analizzato completamente da Karp e Rabin .
Supponendo che la lunghezza del modello non sia più lunga della dimensione della parola di memoria della macchina, l’ algoritmo Shift Or è un algoritmo efficiente per risolvere il problema esatto di corrispondenza delle stringhe e si adatta facilmente a un’ampia gamma di problemi di corrispondenza approssimativa delle stringhe.
Il primo algoritmo di corrispondenza delle stringhe in tempo lineare è di Morris e Pratt . È stato migliorato da Knuth, Morris e Pratt . La ricerca si comporta come un processo di riconoscimento da parte dell’automa, e un carattere del testo viene confrontato con un carattere del pattern non più di log ( m +1) (  è il rapporto aureo
 ). Hancart ha dimostrato che questo ritardo di un algoritmo correlato scoperto da Simon non fa più di 1+log 2 m confronti per carattere di testo. Questi tre algoritmi eseguono al massimo 2 n -1 confronti di caratteri di testo nel caso peggiore.
La ricerca con un automa finito deterministico esegue esattamente n ispezioni di caratteri di testo ma richiede uno spazio extra in O( m ). L’ algoritmo Forward Dawg Matching esegue esattamente lo stesso numero di ispezioni dei caratteri di testo utilizzando l’automa suffisso del modello.
L’ algoritmo Apostolico-Crochemore è un semplice algoritmo che esegue  n confronti di caratteri di testo nel caso peggiore.
L’ algoritmo Not So Naive è un algoritmo molto semplice con una complessità temporale quadratica nel caso peggiore, ma richiede una fase di pre-elaborazione in tempo e spazio costanti ed è leggermente sublineare nel caso medio.Da destra a sinistra
L’ algoritmo di Boyer-Moore è considerato l’algoritmo di corrispondenza delle stringhe più efficiente nelle applicazioni usuali. Una sua versione semplificata (o l’intero algoritmo) è spesso implementata negli editor di testo per i comandi “cerca” e “sostituisci”. Cole ha dimostrato che il numero massimo di confronti di caratteri è strettamente limitato da 3 n dopo la preelaborazione per modelli non periodici. Ha un tempo quadratico nel caso peggiore per i modelli periodici.
Diverse varianti dell’algoritmo di Boyer-Moore evitano il suo comportamento quadratico. Le soluzioni più efficienti in termini di numero di confronti di simboli sono state progettate da Apostolico e Giancarlo , Crochemore et alii ( Turbo BM ) e Colussi ( Reverse Colussi ).
I risultati empirici mostrano che le variazioni dell’algoritmo di Boyer e Moore progettato da Sunday ( Quick Search ) e un algoritmo basato sull’automa suffisso di Crochemore et alii ( Reverse Factor e Turbo Reverse Factor ) sono le più efficienti nella pratica.
Gli algoritmi Zhu e Takaoka e Berry-Ravindran sono varianti dell’algoritmo Boyer-Moore che richiedono uno spazio extra in O ( 2 ).In un ordine specifico
I due primi algoritmi di corrispondenza delle stringhe nello spazio ottimale lineare sono dovuti a Galil-Seiferas e Crochemore-Perrin ( algoritmo a due vie ). Dividono il pattern in due parti, prima cercano la parte destra del pattern da sinistra a destra e poi, se non si verifica alcuna discrepanza, cercano la parte sinistra.
Gli algoritmi di Colussi e Galil-Giancarlo suddividono l’insieme delle posizioni del pattern in due sottoinsiemi. Prima cercano i caratteri del modello le cui posizioni sono nel primo sottoinsieme da sinistra a destra e poi, se non si verifica una mancata corrispondenza, cercano i caratteri rimanenti da sinistra a destra. L’algoritmo Colussi è un miglioramento rispetto all’algoritmo Knuth-Morris-Pratt ed esegue al massimo n confronti di caratteri di testo nel caso peggiore. L’algoritmo Galil-Giancarlo migliora l’algoritmo Colussi in un caso speciale che gli consente di eseguire al massimo  n confronti di caratteri di testo nel caso peggiore.
Gli algoritmi di Sunday’s Optimal Mismatch e Maximal Shift ordinano le posizioni del modello rispettivamente in base alla frequenza dei caratteri e allo spostamento iniziale.
Gli algoritmi Skip Search , KMP Skip Search e Alpha Skip Search di Charras ( et alii ) utilizzano i bucket per determinare le posizioni iniziali sul modello nel testo.In qualsiasi ordine
L’ algoritmo di Horspool è una variante dell’algoritmo di Boyer-Moore , utilizza una delle sue funzioni shift e l’ordine in cui vengono eseguiti i confronti dei caratteri del testo è irrilevante. Questo vale anche per tutte le altre varianti come la Quick Search di Sunday, Tuned Boyer-Moore di Hume e Sunday, l’ algoritmo di Smith e l’ algoritmo di Raita .Definizioni
Prenderemo in considerazione ricerche pratiche. Assumeremo che l’alfabeto sia l’insieme dei codici ASCII o un suo sottoinsieme. Gli algoritmi sono presentati in linguaggio di programmazione C, quindi per una parola w di lunghezza  i caratteri sono w [0], … , w [ -1] e w [ ] contenevano il carattere di fine speciale (carattere nullo) che non può verificarsi da nessuna parte all’interno di ogni parola ma alla fine. Entrambe le parole, il motivo e il testo risiedono nella memoria principale.
Introduciamo alcune definizioni.
Una parola u è un prefisso di una parola w se esiste una parola v (possibilmente vuota) tale che w = uv .
Una parola v è un suffisso di una parola w se esiste una parola u (possibilmente vuota) tale che w = uv .
Una parola z è una sottostringa o una sottoparola o un fattore di una parola w se esistono due parole u e v (possibilmente vuote) tali che w = uzv .
Un intero p è un periodo di una parola w if for i , 0  i < m – p , w [ i ]= w [ i + p ]. Il periodo più piccolo di w è chiamato periodo , è indicato con per ( w ).
Una parola w di lunghezza è periodica se la lunghezza del suo periodo più piccolo è minore o uguale a /2, altrimenti è non periodica .
Una parola w è fondamentale se non può essere scritta come una potenza di un’altra parola: non esistono né una parola z né un intero k tale che w = z k .
Una parola z è un bordo di una parola w se esistono due parole u e v tali che w = uz = zv , z è sia un prefisso che un suffisso di w . Nota che in questo caso | u |=| v | è un periodo di w .
Il rovescio di una parola w di lunghezza indicata con w R è l’immagine speculare di w ; w R = w [ -1] w [ -2] … w [1] w [0].
Un Automa Finito Deterministico (DFA) A è un quadruplo ( Q , q 0 , T , E ) dove:
 | Q è un insieme finito di stati; |
| | q 0 in Q è lo stato iniziale; |
| | T , sottoinsieme di Q , è l’insieme degli stati terminali; |
| | E, sottoinsieme di ( Q .. Q ), è l’insieme delle transizioni. |
La lingua L ( A ) definita da A è il seguente insieme: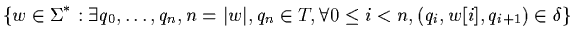
Per ogni algoritmo esatto di string-matching presentato nel presente libro diamo prima le sue caratteristiche principali, poi abbiamo spiegato come funziona prima di dare il suo codice C. Successivamente mostriamo il suo comportamento su un tipico esempio dove x =GCAGAGAG ey =GCATCGCAGAGAGTATACAGTACG. Infine diamo un elenco di riferimenti dove il lettore troverà presentazioni e dimostrazioni più dettagliate dell’algoritmo. Ad ogni tentativo, le corrispondenze vengono materializzate in grigio chiaro mentre le discrepanze vengono mostrate in grigio scuro. Un numero indica l’ordine in cui vengono eseguiti i confronti dei caratteri, ad eccezione degli algoritmi che utilizzano gli automi, dove il numero rappresenta lo stato raggiunto dopo l’ispezione dei caratteri.Implementazione
In questo libro, usiamo stringhe C e assumiamo che una stringa di lunghezza m contenga un simbolo ( m +1)-esimo (di solito assegnato con il valore ‘\0’). In caso contrario, alcune implementazioni di algoritmi potrebbero andare in crash quando si accede a una posizione appena oltre l’effettivo ultimo carattere di una stringa. (Grazie a David B. Trout di Software Development Laboratories per aver indicato questo punto particolare).
In questo libro useremo strumenti classici. Uno di questi è un elenco collegato di numeri interi. Sarà definito in C come segue:
  struct _cell{
    int elemento;
    struct _cell *next;
  };

  typedef struct _cell *Lista;
Altre strutture importanti sono gli automi e in particolare gli automi suffissi (vedi capitolo 22 ). Fondamentalmente gli automi sono grafi diretti. Useremo la seguente interfaccia per manipolare gli automi:
  Grafico newGraph(int v, int e);
  Grafico newAutomaton(int v, int e);
  Grafico newSuffixAutomaton(int v, int e);
  int newVertex(Grafico g);
  int getInitial(Grafico g);
  isTerminal booleano(Grafico g, int v);
  void setTerminal(Grafico g, int v);
  int getTarget(Graph g, int v, unsigned char c);
  void setTarget(Graph g, int v, unsigned char c, int t);
  int getSuffixLink(Grafico g, int v);
  void setSuffixLink(Graph g, int v, int s);
  int getLength(Grafico g, int v);
  void setLength(Graph g, int v, int ell);
  int getPosition(Grafico g, int v);
  void setPosition(Grafico g, int v, int p);
  int getShift(Graph g, int v, unsigned char c);
  void setShift(Graph g, int v, unsigned char c, int s);
  void copyVertex(Graph g, int target, int source);
Segue una possibile implementazione di questa interfaccia.
  struct _graph {
    int vertexNumber,
        edgeNumber,
        vertexCounter,
        initial,
        *terminal,
        *target,
        *suffixLink,
        *length,
        *position,
        *shift;
  };

  typedef struct _graph *Graph;
  typedef int booleano;

#define UNDEFINED -1

/* restituisce una nuova struttura dati per
   un grafo con v vertici ed e
archi */ Graph newGraph(int v, int e) {
   Graph g;

   g = (Graph)calloc(1, sizeof(struct _graph));
   if (g == NULL)
      error("newGraph");
   g->numero vertice = v;
   g->edgeNumber = e;
   g->iniziale = 0;
   g->vertexCounter = 1;
   ritorno(g);
}


/* restituisce una nuova struttura dati per
   un automa con v vertici ed e bordi */
Graph newAutomaton(int v, int e) {
   Graph aut;

   aut = newGraph(v, e);
   aut->target = (int *)calloc(e, sizeof(int));
   if (aut->target == NULL)
      error("newAutomaton");
   aut->terminal = (int *)calloc(v, sizeof(int));
   if (aut->terminal == NULL)
      error("newAutomaton");
   ritorno(auto);
}


/* restituisce una nuova struttura dati per
   un automa suffisso con v vertici ed e bordi */
Graph newSuffixAutomaton(int v, int e) {
   Graph aut;

   aut = nuovoAutoma(v,e);
   memset(aut->target, UNDEFINED, e*sizeof(int));
   aut->suffixLink = (int *)calloc(v, sizeof(int));
   if (aut->suffixLink == NULL)
      error("newSuffixAutomaton");
   aut->lunghezza = (int *)calloc(v, sizeof(int));
   if (aut->length == NULL)
      error("newSuffixAutomaton");
   aut->posizione = (int *)calloc(v, sizeof(int));
   if (aut->position == NULL)
      error("newSuffixAutomaton");
   aut->shift = (int *)calloc(e, sizeof(int));
   if (aut->shift == NULL)
      error("newSuffixAutomaton");
   ritorno(auto);


   un trie con v vertici ed e bordi */
Graph newTrie(int v,

   aut = newAutomaton(v, e);
   memset(aut->target, UNDEFINED, e*sizeof(int));
   aut->suffixLink = (int *)calloc(v, sizeof(int));
   if (aut->suffixLink == NULL)
      errore("newTrie");
   aut->lunghezza = (int *)calloc(v, sizeof(int));
   if (aut->length == NULL)
      error("newTrie");
   aut->posizione = (int *)calloc(v, sizeof(int));
   if (aut->position == NULL)
      error("newTrie");
   aut->shift = (int *)calloc(e, sizeof(int));
   if (aut->shift == NULL)
      error("newTrie");
   ritorno(auto);


   if (g != NULL && g->
      return(g->vertexCounter++);
   errore("nuovo vertice");
}


/* restituisce il vertice iniziale del grafo g */
int getInitial(Graph g) {
   if (g != NULL)
      return(g->initial);
   errore("getInitial");
}


/* restituisce true se il vertice v è terminale nel grafico g */
booleano isTerminal(Graph g, int v) {
   if (g != NULL && g->terminal != NULL &&
       v < g->vertexNumber)
      return(g -> terminale[v]);
   error("isTerminal");
}


/* imposta il vertice v come terminale nel grafico g */
void setTerminal(Graph g, int v) {
       v < g->vertexNumber)
      g->terminal[v] = 1;
      error("isTerminal");
}


/* restituisce il target del bordo dal vertice v
   etichettato dal carattere c nel grafico g */
int getTarget(Graph g, int v, unsigned char c) {
   if (g != NULL && g->target != NULL &&
       v < g->NumeroVertice && v*c < g->NumeroEdge)
      return(g->target[v*(g->NumeroEdge/g->NumeroVertice) +
                       c]);
   errore("getTarget");
}


/* aggiunge il bordo dal vertice v al vertice t
   etichettato dal carattere c nel grafico g */
void setTarget(Graph g, int v, unsigned char c, int t) {
   if (g != NULL && g->target ! = NULL &&
       v*c <= g->edgeNumber && t < g->vertexNumber)
      g->target[v*(g->edgeNumber/g->vertexNumber) + c] = t;
   else
      errore("setTarget");
}


/* restituisce il collegamento suffisso del vertice v nel grafico g */
int getSuffixLink(Graph g, int v) {
   if (g != NULL && g->suffixLink != NULL &&
       v < g->vertexNumber)
      return(g ->suffissoLink[v]);
   error("getSuffixLink");
}


/* imposta il collegamento del suffisso del vertice v
   al vertice s nel grafico g */
void setSuffixLink(Graph g, int v, int s) {
   if (g != NULL && g->suffixLink != NULL &&
       v < g- >Numero vertice &&
      s < g->vertexNumber) g->suffixLink[v] = s;
   altro
      error("setSuffixLink");
}


/* restituisce la lunghezza del vertice v nel grafico g */
int getLength(Graph g, int v) {
   if (g != NULL && g->length != NULL &&
       v < g->vertexNumber)
      return(g-> lunghezza[v]);
   errore("getLength");
}


/* imposta la lunghezza del vertice v
sull'intero ell nel grafico g */ void setLength(Graph g, int v, int ell) {
   if (g != NULL && g->length != NULL &&
       v < g-> vertexNumber)
      g->lunghezza[v] = ell;
   else
      errore("setLength");
}


/* restituisce la posizione del vertice v nel grafico g */
int getPosition(Graph g, int v) {
       v < g->
   errore("getPosition");
}


/* imposta la lunghezza del vertice v all'intero ell nel grafico g */
void setPosition(Graph g, int v, int p) {
   if (g != NULL && g->position != NULL &&
       v < g-> vertexNumber)
      g->posizione[v] = p;
   else
      errore("setPosition");
}


/* restituisce lo spostamento del bordo dal vertice v
   etichettato dal carattere c nel grafico g */
int getShift(Graph g, int v, unsigned char c) {
   if (g != NULL && g->shift != NULL &&
       v < g->NumeroVertice && v*c < g->NumeroEdge)
      return(g->shift[v*(g->NumeroEdge/g->Numerovertice) +
   errore("getShift");
}


/* imposta lo spostamento del bordo dal vertice v
   etichettato dal carattere c all'intero s nel grafico g */
void setShift(Graph g, int v, unsigned char c, int s) {
   if (g != NULL && g- >shift != NULL &&
       v < g->vertexNumber && v*c <= g->edgeNumber)
      g->shift[v*(g->edgeNumber/g->vertexNumber) + c] = s;
   else
      errore("setShift");
}


/* copia tutte le caratteristiche della sorgente del
   vertice nella destinazione del vertice nel grafico g */
void copyVertex(Graph g, int target, int source) {
   if (g != NULL && target < g->vertexNumber &&
       source < g->
         memcpy(g->
                g->target +
                source*(g->edgeNumber/g->vertexNumber),
                (g->edgeNumber/g->vertexNumber)*
                sizeof(int));
      if (g->shift != NULL)
         memcpy(g->shift +
                target*(g->edgeNumber/g->vertexNumber),
                g->shift +
                source*(g->edgeNumber/g->vertexNumber),
                g->edgeNumber/g->vertexNumber)*
                sizeof(int));
      if (g->terminal != NULL)
         g->terminal[target] = g->terminal[source];
      if (g->suffixLink != NULL)
         g->length[target] = g->
         g->suffixLink[target] = g->
      if (g->lunghezza != NULL)
      if (g->posizione != NULL)
         g->posizione[destinazione] = g->posizione[sorgente];
   }
   else
      errore("copyVertex");
}
e-mails: {Christian.Charras, Thierry.Lecroq} @laposte.net
Tue Jan 14 15:03:31 MET 1997
